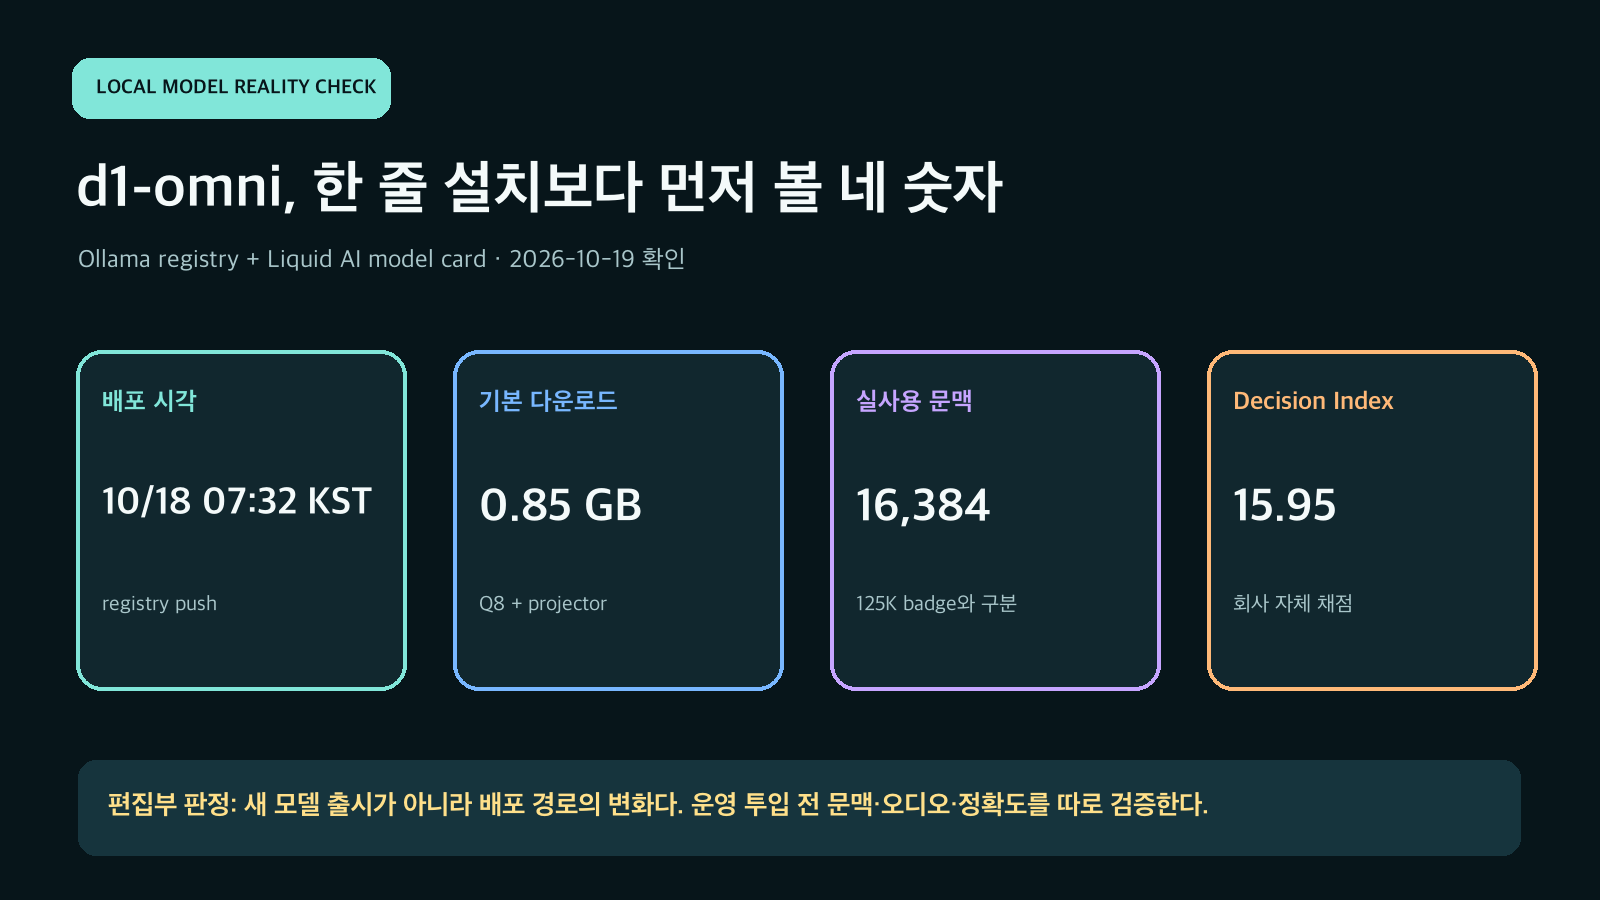
한 줄 설치는 확인됐지만 125K 표기, 오디오 요청 형식, 회사 자체 정확도는 운영 근거로 부족하다. 16,384 문맥과 사람 이관을 기준으로 150개 결정·100회 연속 요청을 검증해야 한다.
- registry 등록
- 2026-10-18 07:32:13 KST 근거 ↗
- 기본 다운로드
- 0.85 GB 근거 ↗
- 실사용 문맥
- 16,384 positions 근거 ↗
- 이미지 텍스트
- 896 tokens 근거 ↗
- Decision Index
- 15.95 vendor-scored 근거 ↗
- 7개 벤치 평균
- 78.4 vendor-reported 근거 ↗
자료 조사·초안 구성에 자동화 도구를 활용할 수 있으며, 공개된 글의 수정과 최종 책임은 트렌드매그 운영자에게 있습니다.
결론부터 말하면 Liquid AI의 587M 결정 모델 d1-omni가 Ollama에 들어오면서 로컬 분류·라우팅 실험의 설치 장벽은 크게 낮아졌다. 다만 125K 문맥 표기, 오디오 요청 형식, 회사 자체 점수는 그대로 믿으면 안 된다. 고객 문의·이미지 검사·음성 명령을 자동 분류하려는 개발팀은 16,384 문맥과 실패 시 사람 이관을 기준으로 먼저 검증해야 한다.
작성자: 트렌드매그 편집부 · 검수자: 트렌드매그 AI 편집 기준 · 최종 업데이트일: 2026-10-19 (Asia/Seoul) · 직접 테스트: 하지 않음
먼저 확인한 사실 표
| 항목 | 2026-10-19 확인값 | 증거 상태 |
|---|---|---|
| 이번 변화 | ollama pull d1-omni 공식 레지스트리 등록 |
모델 신제품이 아니라 새 배포 경로다. |
| 등록 시각 | 2026-10-18 07:32:13 KST | 레지스트리 ollama-push-time 헤더로 확인했다. |
| 기본 패키지 | 0.85GB, 587M 파라미터 | Ollama 페이지와 Liquid AI 카드가 일치한다. |
| 실사용 문맥 | 16,384 positions, 이미지 동반 텍스트 896 | Ollama 태그의 125K 표시는 아키텍처 상한과 구분해야 한다. |
| 입력 | 텍스트+이미지 또는 텍스트+영어 음성 30초 | 이미지와 음성을 한 요청에 같이 넣을 수 없다. |
| 정확도 | Decision Index 15.95, 7개 벤치 평균 78.4 | Liquid AI 자체 채점이며 독립 재현값이 아니다. |
무엇이 바뀌었는가: 모델이 아니라 설치 경로다
d1-omni-600M은 10월 7일 이미 공개된 모델이다. 따라서 이번 소식을 “10월 18일 새 모델 출시”로 부르면 틀린다. 새로 생긴 것은 Ollama 공식 라이브러리의 d1-omni 이름이다. 이전에는 Hugging Face의 사용자 정의 코드에 trust_remote_code=True를 쓰거나 GGUF와 llama.cpp 구성을 직접 다뤄야 했다. 이제 Ollama 0.40.4 이상에서는 모델 이름 하나로 기본 패키지를 받을 수 있다.
이 변화가 중요한 이유는 결정 모델이 챗봇과 다르기 때문이다. d1-omni는 문장을 생성하지 않고, 한 상태에 대해 yes/no·선택지·등급 질문을 한 번의 forward pass로 평가해 확률을 돌려준다. 예를 들어 고객 문의를 환불·기술·영업으로 라우팅하거나, 상품 사진의 파손 여부를 판정하거나, 영어 음성 명령의 의도를 분류할 수 있다. 출력 토큰은 0이며 생성형 답변 대신 구조화된 결정을 만드는 도구다.
레지스트리의 최신 manifest digest는 1ba59f63e836…이고 등록 시각은 UTC 10월 17일 22:32:13, 한국 시각 10월 18일 07:32:13이다. 최신성의 근거는 홍보 글 날짜가 아니라 이 서버 헤더다. 기본 태그·600m·600m-q8_0은 같은 manifest를 가리키고, bf16은 별도 1.2GB 빌드다.
실제 사용자에게 미치는 영향
개인 개발자와 소규모 팀은 0.85GB 패키지로 로컬 분류기를 빨리 시험할 수 있다. 입력을 외부 API에 보내지 않는 구조를 설계하기 쉬워지고, 인터넷이 끊겨도 문의 라우팅·검수 같은 좁은 작업을 계속할 수 있다. 하지만 로컬 실행이 곧 개인정보보호 준수를 보장하지는 않는다. 로그, 원본 이미지·음성 보존, 접근권한, 모델 업데이트 기록을 별도로 관리해야 한다.
문맥 길이는 가장 먼저 바로잡아야 한다. Ollama 태그 화면에 보이는 125K는 trunk GGUF의 128,000 아키텍처 값에서 온다. 실제 패키지 parameters와 Liquid AI 모델 카드는 텍스트·이미지·오디오 위치를 합쳐 16,384로 고정한다. 이미지를 넣으면 상태와 질문 텍스트는 훈련 조건상 896 토큰으로 잘린다. 긴 계약서나 상담 기록을 통째로 넣는 장문 분류기라면 “125K 로컬 모델”로 설계해서는 안 된다.
오디오도 조건부다. 모델 카드와 GGUF 예시는 16kHz 모노 음성을 30초까지 지원한다. 하지만 Liquid GGUF 문서는 files 배열을 쓰고, Ollama d1-omni 페이지는 WAV를 images 배열에 넣는다. Ollama의 일반 System One 문서는 이미지 형식만 명시하고 오디오 필드를 설명하지 않는다. 음성 기능은 패키지 안에 있지만 요청 스키마가 문서마다 다르므로, 운영 계약으로 보기 전에 실제 버전에서 성공·실패 응답을 고정해야 한다.

고유 결과물 1: 125K 배지와 실제 운영값 분리표
| 화면·문서 | 보이는 값 | 운영에서 쓸 값 | 판정 |
|---|---|---|---|
| Ollama 태그 배지 | 125K | 참고만 함 | trunk 아키텍처 상한 |
| 패키지 parameters | 16,384 | 16,384 | 로컬 runner 문맥 |
| Liquid AI 모델 카드 | 16,384 | 16,384 | 세 모달리티 합산 |
| 이미지 동반 요청 | 텍스트 896 | 896 이하로 테스트 | 훈련 조건상 잘림 |
| 음성 | 영어 30초 | 30초 이하, 영어부터 | 한국어 품질 근거 없음 |
트렌드매그 판정은 단순하다. 모델 목록의 큰 숫자가 아니라 실제 runner가 읽는 parameters와 공급자 카드의 제한을 낮은 쪽으로 적용한다. 한국어 음성은 지원 목록에 언어 이름이 있더라도 오디오 훈련 설명이 영어 요청으로 한정되므로, 별도 한국어 테스트셋 없이는 지원으로 간주하지 않는다.
고유 결과물 2: 150건으로 끝내는 로컬 검증 워크플로
- 업무 50건을 먼저 라벨링한다. 정상 30건, 경계 10건, 일부러 헷갈리게 만든 10건으로 구성하고 사람이 정답과 이관 조건을 확정한다.
- 세 번 반복해 150개 결정을 만든다. 같은 입력의 선택이 바뀌는지, 확률이 흔들리는지, HTTP 오류가 생기는지 기록한다.
- 문맥 계단을 밟는다. 512·2,048·8,192·16,384 positions에서 정확도와 지연을 따로 잰다. 이미지는 텍스트 896 이하로 별도 군을 만든다.
- 오류를 비용으로 바꾼다. 오분류 비용, 사람 재검수 시간, 메모리 사용량, p50·p95 지연을 성공 결정 1건 기준으로 계산한다.
- 낮은 확률은 사람에게 보낸다. 예를 들어 최고 선택 확률 0.80 미만 또는 1·2위 차이 0.15 미만을 이관하되, 임계값은 결과를 보기 전에 고정한다.
- 연속 운전을 시험한다. 이미지 100건 이상을 재시작 없이 보내고 HTTP 500, 메모리 슬롯, 모델 재로딩을 확인한다.
배포 기준 예시는 “중대한 오분류 0건, 전체 macro-F1 0.90 이상, p95 500ms 이하, 100회 연속 요청 오류 0건”이다. 이는 권장 임계값이 아니라 팀이 결과 전에 써둘 통과선의 예시다. 실제 업무 위험에 맞춰 더 엄격하게 바꿔야 한다.
국내 크리에이터·전문 블로그의 실전 사례
지정된 벤치마킹 자료 중 OrcaRouter는 10월 17일 레지스트리 manifest와 패키지 blob을 읽어 0.85GB·16,384 문맥·오디오 스키마 차이를 정리했다. 이 글은 이번 배포 변화와 직접 관련돼 사용했다. 다만 OrcaRouter는 모델 라우팅 서비스를 판매하며 d1-omni를 직접 제공하지 않으므로, 운영 대안과 제품 평가는 상업적 맥락으로 분리했다.
MindStudio의 평가 루프 글은 테스트를 출력 뒤에 만들면 자기확증이 생기므로 실패 조건과 이진 판정을 먼저 작성하라고 권한다. 이 원칙을 위 50건 라벨·통과선 사전 고정에 반영했다. MindStudio 역시 워크플로 제품을 판매하며 d1-omni를 직접 평가한 자료는 아니다. 지정 유튜브 채널에서는 공개 자막·설명으로 이번 Ollama 패키지를 검증할 만한 사례를 찾지 못해 제목이나 썸네일을 근거로 쓰지 않았다.
회사 주장과 트렌드매그 판정의 구분
| 주장·관찰 | 근거 | 트렌드매그 판정 |
|---|---|---|
| 한 줄로 로컬 실행 | Ollama 공식 사용 예 | 설치 경로 개선은 확인했다. 운영 안정성까지 확인한 것은 아니다. |
| 세 모달리티 지원 | Liquid 모델 카드·패키지 | 모델 능력은 확인. Ollama 오디오 스키마는 문서 불일치가 남는다. |
| 7개 벤치 평균 78.4 | Liquid AI 자체 평가 | 회사 주장. 한국어·사내 데이터 성능으로 일반화하지 않는다. |
| d1보다 훨씬 작음 | 0.85GB 대 3.7GB | 다운로드 약 77% 감소. Decision Index는 15.95 대 48.57로 격차가 크다. |
| 로컬이라 안전함 | 회사 사용 사례 | 전송 최소화 장점은 있으나 로그·권한·보존 정책이 없으면 안전 보장이 아니다. |
직접 재현 가능한 검증 절차
Ollama 0.40.4 이상에서 manifest digest와 ollama show d1-omni --parameters 결과를 기록한 뒤, 텍스트 yes/no·choice·score를 각 10건 실행한다. 다음으로 이미지 20건을 896 토큰 이하 설명과 함께 보내고, 마지막으로 영어 16kHz 모노 WAV 10건을 30초 이하로 보낸다. 오디오가 실패하면 images와 files 형식을 섞어 우회하지 말고 문서·버전 불일치로 기록한다. 모델을 재시작하지 않은 연속 100회에서 상태 코드와 메모리 사용량도 남긴다.
트렌드매그는 이번 실행에서 Ollama를 설치하거나 0.85GB 모델을 내려받지 않았고, 텍스트·이미지·음성 추론을 실행하지 않았다. 레지스트리 헤더와 공식 문서·모델 카드·공개 이슈를 대조했으므로 hands_on_tested=false다.
반론과 과장 가능성
- “회사 자체 점수라 쓸모없다”도 과하다. 공개 가중치와 공식 scorer가 있어 독립 재현이 가능한 출발점이다.
- “0.85GB면 3B d1을 대체한다”는 결론은 틀리다. 다운로드는 약 77% 작지만 Decision Index는 약 67% 낮다.
- “125K 표기는 허위”라고 단정할 수 없다. 아키텍처 메타에는 128K가 있으나 현재 패키지의 runner 값과 훈련 제한이 더 낮다는 문제다.
- “오디오 예제가 있으니 지원이 안정적”도 아니다. 공식 문서끼리 요청 필드가 다르고 한국어 음성 성능 자료가 없다.
- 공개 GitHub 이슈 하나는 결함 확정이 아니다. d1 이미지 연속 요청의 HTTP 500 보고는 재현되지 않은 사용자 사례라 장시간 시험 항목으로만 반영했다.
분석의 한계
- d1-omni 정확도와 지연을 독립적으로 실행하지 않았다.
- Decision Index 값은 공급자 자체 채점이며 공개 leaderboard 제출값이 아니다.
- Ollama 문서와 패키지는 빠르게 바뀔 수 있어 digest·버전을 함께 기록해야 한다.
- 오디오의 Ollama 요청 형식과 한국어 품질은 확인되지 않았다.
- 커뮤니티의 d1 이미지 HTTP 500 보고는 d1-omni의 확정 결함이 아니다.
지금 할 일
도입 후보라면 오늘 해야 할 일은 모델을 서비스에 연결하는 것이 아니라 50건 정답 세트를 만드는 것이다. 문맥은 16,384, 이미지는 텍스트 896, 음성은 영어 30초를 상한으로 잡고 낮은 확률을 사람에게 보내는 경로부터 설계한다. 전체 도입 순서는 AI 도입 로드맵, 후보 도구는 AI 도구, 편집부 검증 원칙은 AI 인사이트에서 이어진다. 같은 결정 모델 범주는 Cloudflare Clef-omni 분석, 안전 게이트 설계는 Security-One 27B 분석과 비교할 수 있다.
3줄 요약
- d1-omni는 10월 18일 07:32 KST Ollama 공식 레지스트리에 추가돼 0.85GB 로컬 결정 모델을 한 줄로 받을 수 있게 됐다.
- 125K 배지 대신 16,384 문맥, 이미지 요청의 896 텍스트, 영어 음성 30초를 실제 운영 상한으로 봐야 한다.
- 정확도는 회사 자체 점수이고 오디오 문서도 불일치하므로, 50건×3회와 100회 연속 요청을 통과한 뒤 제한 배포한다.
공식 출처
- Ollama d1-omni 공식 라이브러리 페이지
- Ollama registry manifest — push time·digest
- Liquid AI d1-omni-600M 공식 모델 카드
- Liquid AI 공식 GGUF 사용 문서
- Liquid AI Open d1 발표 — 2026-10-07
- Ollama System One 결정 모델 문서