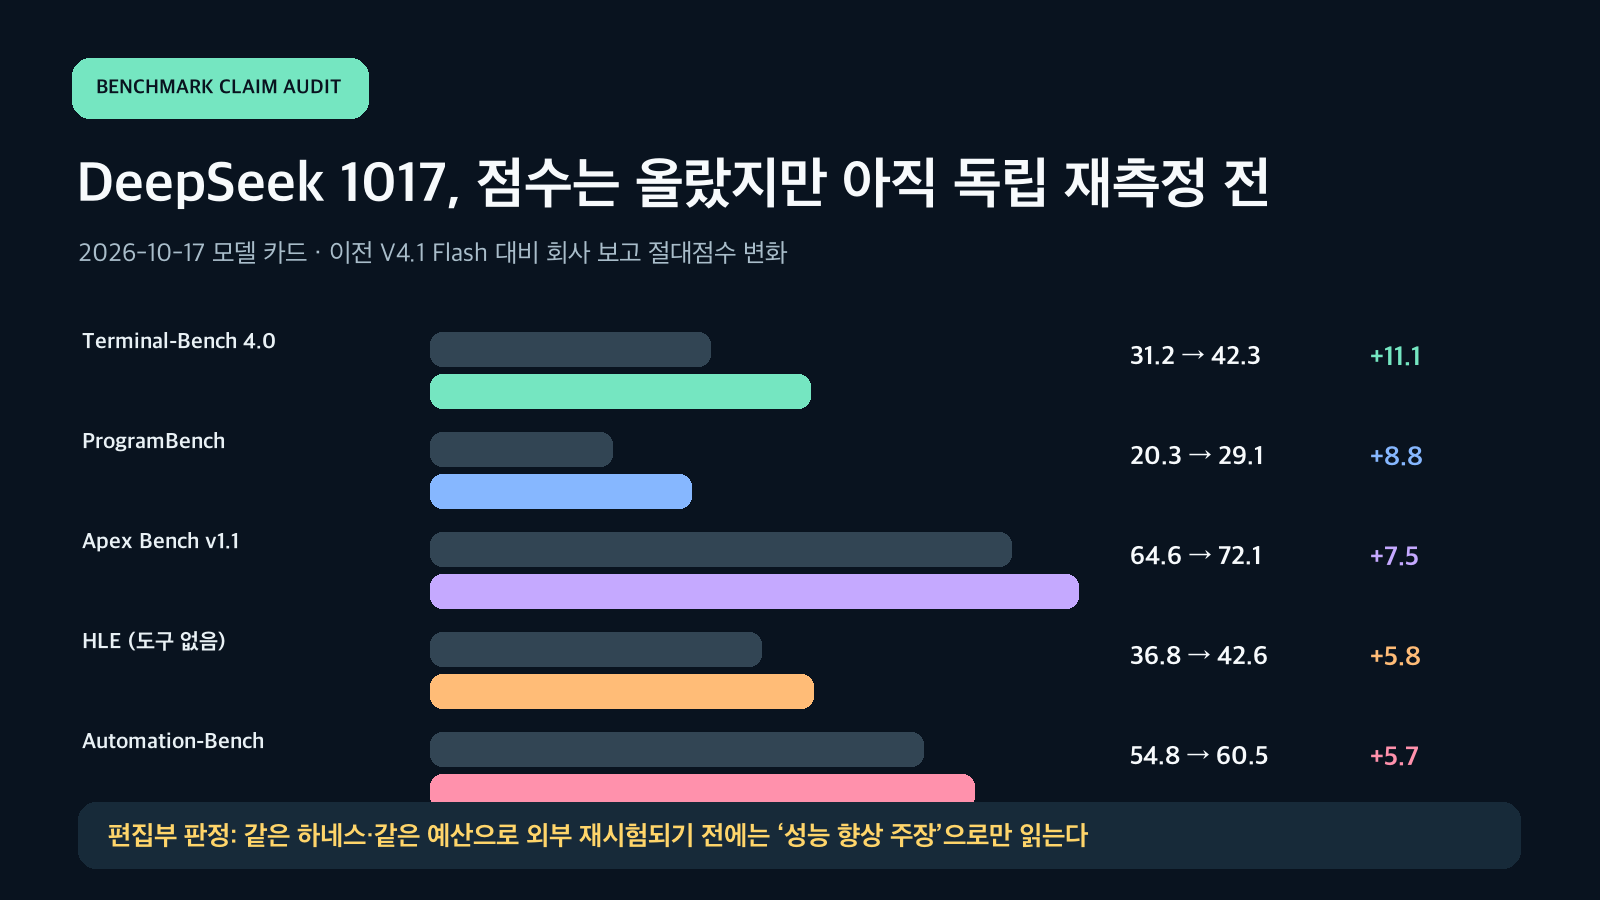
1017은 가격·API 이름을 유지한 유의미한 교체지만 11개 향상 수치는 아직 회사 평가다. 운영팀은 같은 하네스의 고정 30개 과제로 완료율과 성공 작업당 비용을 재측정해야 한다.
- 업데이트
- 2026-10-17 근거 ↗
- Terminal-Bench 4.0
- 31.2 to 42.3 (+11.1) 근거 ↗
- ProgramBench
- 20.3 to 29.1 (+8.8) 근거 ↗
- 비피크 가격
- $0.15 input / $0.60 output 근거 ↗
- 월 가상 비용
- $27 no cache / $15.24 at 80% input cache 근거 ↗
- 독립 1017 점수
- not yet available 근거 ↗
자료 조사·초안 구성에 자동화 도구를 활용할 수 있으며, 공개된 글의 수정과 최종 책임은 트렌드매그 운영자에게 있습니다.
결론부터 말하면 DeepSeek‑V4.1‑Flash‑1017은 기존 API 이름과 가격을 유지한 채 코딩·에이전트 점수를 높였다고 발표한 무료 교체다. 그러나 11개 향상 수치는 아직 모두 회사 평가다. 이미 deepseek-flash를 쓰는 개발팀은 “자동으로 좋아졌다”고 끝내지 말고, 고정 테스트 30개와 작업당 비용으로 1017 버전을 다시 검증해야 한다.
작성자: 트렌드매그 편집부 · 검수자: 트렌드매그 AI 편집 기준 · 최종 업데이트일: 2026-10-18 (Asia/Seoul) · 직접 테스트: 하지 않음
먼저 확인한 사실 표
| 항목 | 2026-10-18 확인값 | 트렌드매그 판정 |
|---|---|---|
| 발표일 | 2026년 10월 17일 | 실행 시점 기준 최근 48시간 안의 실질 업데이트다. |
| API 버전 | deepseek-flash가 1017을 제공 |
모델 ID가 같아도 결과가 바뀔 수 있으므로 앱 버전 기록만으로는 부족하다. |
| 가격 | 비피크 입력/출력 $0.15/$0.60, 피크 $0.30/$1.20 per 1M | 단가는 유지됐지만 실제 작업비는 출력 길이와 재시도율을 함께 봐야 한다. |
| 공개 범위 | 웹·앱·API 교체, MIT 가중치 공개 | API 이용과 자체 호스팅은 비용·운영 난도가 전혀 다른 선택이다. |
| 문맥·출력 상한 | 1M 문맥, API 최대 출력 384K | 상한은 품질 보증이 아니다. 실제 업무 길이에서 검증해야 한다. |
| 평가 상태 | 회사 표는 11개 지표 모두 상승, 1017 독립 점수는 아직 없음 | “향상 주장”은 확인됐지만 “독립적으로 향상 확인”은 아니다. |
무엇이 바뀌었는가: 새 이름보다 조용한 교체가 중요하다
DeepSeek 변경 기록은 10월 17일 V4.1 Flash를 DeepSeek‑V4.1‑Flash‑1017로 올렸고, 웹과 앱 모델도 함께 갱신했다고 적었다. 호출 방법과 가격은 바뀌지 않았다. 개발자는 계속 deepseek-flash를 사용한다. 새 모델 ID로 마이그레이션할 필요가 없다는 뜻이지만, 반대로 같은 코드가 어제와 다른 가중치·행동을 만날 수 있다는 뜻이기도 하다.
모델 카드는 추론, 코딩, 에이전트, 시각 벤치마크가 함께 상승했고 작업 시간과 출력 길이도 줄었다고 주장한다. 수치가 가장 크게 오른 항목은 Terminal‑Bench 4.0의 31.2→42.3, ProgramBench의 20.3→29.1, Apex Bench v1.1의 64.6→72.1이다. DeepSWE v1.1은 74.2→77.0으로 변화 폭이 상대적으로 작다. “11개가 모두 올랐다”는 사실과 “내 업무도 같은 폭으로 좋아진다”는 결론 사이에는 하네스·프롬프트·도구·재시도 정책이라는 빈칸이 있다.
프롬프트 형식도 그냥 넘기면 안 된다. 이번 공개에는 흔히 쓰는 Jinja 채팅 템플릿이 없다. 저장소의 Python 참조 인코더 또는 Rust와 Python 바인딩으로 제공되는 deepseek-recipe를 사용하라고 안내한다. 메시지, 도구 호출, 추론 노력, 중간 시스템 메시지, 이미지가 섞인 대화를 자체 템플릿으로 대충 조립하면 벤치마크 조건과 다른 모델을 시험하는 셈이다.
실제 사용자에게 미치는 영향
첫째, 별도 마이그레이션 없이 응답 특성이 달라질 수 있다. 운영 서비스가 deepseek-flash라는 이동 별칭만 저장한다면 장애가 난 뒤 9월 버전과 1017 중 무엇이 답했는지 재구성하기 어렵다. 요청 로그에 공급자 버전, 날짜, 추론 모드, temperature, top_p, 최대 출력, 하네스 버전을 함께 남겨야 한다.
둘째, 가격표가 같아도 비용은 달라질 수 있다. DeepSeek은 출력이 짧아지고 작업 시간이 줄었다고 했지만 절감 비율을 공개하지 않았다. 짧은 출력이 재시도를 줄이는지, 필요한 설명까지 생략하는지는 작업별로 다르다. “토큰 단가 유지”와 “작업당 총비용 감소”를 같은 문장으로 쓰면 안 된다.
셋째, 공개 가중치가 곧 노트북에서의 로컬 실행을 뜻하지 않는다. Hugging Face 페이지는 현재 763B 파라미터로 표시하고, 독립 매체는 체크포인트 약 510GB를 계산한다. 9월 공식 설명의 552B는 계산 백본 범주여서 저장소 전체 카운트와 같은 범위로 단정할 수 없다. 대부분의 개인 개발자는 API 검증부터 시작하고, 자체 호스팅은 하드웨어·양자화·서빙 엔진·보안 비용을 별도 사업으로 봐야 한다.

고유 결과물 1: 같은 가격표를 월 작업비로 바꾸기
월 1억 개의 입력 토큰과 2천만 개의 출력 토큰을 쓴다고 가정하자. 캐시가 없다면 비피크 비용은 100×$0.15 + 20×$0.60 = $27, 피크는 100×$0.30 + 20×$1.20 = $54다. 입력의 80%가 캐시에 정확히 적중한다면 비피크는 80×$0.003 + 20×$0.15 + 20×$0.60 = $15.24다. 피크는 $30.48이다.
이 계산은 비교 가능한 기준일 뿐 실제 청구 예측이 아니다. 토큰 수, 캐시 적중 정의, 중국 공휴일을 포함한 비피크 시간, 라우터 수수료, 환율과 세금이 달라질 수 있다. 특히 1017이 출력을 얼마나 줄였는지 비율이 없으므로 임의의 20% 절감 같은 값을 넣지 않았다. 비용 실험에서는 성공한 작업 1건당 총토큰과 사람이 수정한 시간을 함께 기록해야 한다.
고유 결과물 2: 회사 표를 ‘증거 상태’로 다시 읽기
| 벤치마크 | 이전 | 1017 | 절대 변화 | 현재 증거 상태 |
|---|---|---|---|---|
| Terminal‑Bench 4.0 | 31.2 | 42.3 | +11.1 | DeepSeek, Claude Code 하네스 |
| ProgramBench | 20.3 | 29.1 | +8.8 | DeepSeek 자체 표 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 | DeepSeek 자체 표 |
| HLE, 도구 없음 | 36.8 | 42.6 | +5.8 | 회사 평가, 텍스트 부분 별도 표기 |
| Automation‑Bench | 54.8 | 60.5 | +5.7 | DeepSeek 자체 표 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 | DeepSeek, Mini‑SWE‑V2 하네스 |
Ridge는 1017에 대한 독립 점수가 아직 없다고 명시했다. 기존 보드의 Artificial Analysis Index 39, Vals Terminal‑Bench 19.7 등은 9월 빌드 결과라 1017 표에 섞어서는 안 된다. 특히 DeepSeek은 Terminal‑Bench 4.0에 Claude Code 하네스를 사용했고, Vals는 다른 하네스를 썼다. 같은 벤치마크 이름이라도 에이전트 포장과 도구 구성이 다르면 결과가 크게 달라질 수 있다.
국내 크리에이터·전문 블로그의 실전 사례
지정된 벤치마킹 목록 가운데 MindStudio는 10월 17일 업데이트 글에서 1017의 표를 정리하면서도 Jinja 템플릿 부재와 별도 인코더 필요를 운영 마찰로 지적했다. 다만 MindStudio는 자체 AI 워크플로 제품을 판매하므로 “도입 가치” 평가는 상업적 맥락으로 분리하고, 공개 사양과 통합 주의점만 참고했다.
DataCamp의 9월 V4.1 Flash 분석은 가격이 싸도 가장 어려운 에이전트 평가에서 점수가 급격히 내려갈 수 있다고 지적한다. OrcaRouter의 OpenCode 가이드는 추론 노력 설정이 일부 하네스에서 조용히 무시될 수 있고, 과도한 추론이 실사용 실패로 이어질 수 있다고 설명한다. 두 자료 모두 1017 독립 평가가 아니라 이전 빌드의 통합 경험이다. 새 버전의 성능 증거로 재사용하지 않고, 테스트 설계의 실패 사례로만 썼다.
지정된 국내외 유튜브 채널도 확인했지만 발표 후 48시간 안에 영상 설명·챕터·공개 자막으로 1017을 검증할 수 있는 관련 사례는 찾지 못했다. 썸네일이나 제목만으로 “실사용 검증”을 만들지 않았다.
회사 주장과 트렌드매그 판정의 구분
| 주장·사실 | 근거 | 트렌드매그 판정 |
|---|---|---|
| 11개 공개 점수가 모두 상승 | 공식 모델 카드의 동일 표 | 회사 비교로는 확인. 외부 재현 전에는 일반 성능 향상으로 확정하지 않는다. |
| 작업 시간이 짧아짐 | 회사 설명, 세부 시간표 없음 | 방향성 주장. 작업별 시간과 실패율을 직접 재야 한다. |
| 출력 길이가 줄어 비용 절감 | 회사 설명, 감소율 없음 | 토큰 단가 불변은 확인. 작업당 절감액은 미확인이다. |
| API 가격은 그대로 | 10월 17일 변경 기록과 현재 가격표 | 확인. 다만 피크/비피크·캐시 여부를 구분해야 한다. |
| MIT 가중치 공개 | Hugging Face 라이선스 | 확인. 공개 가중치와 저비용 자체 호스팅은 다른 주장이다. |
| 1017이 경쟁 모델보다 우수 | DeepSeek이 고른 비교 모델·하네스 | 현재 프런티어 전체와의 독립 비교로 보기 어렵다. |
직접 재현 가능한 7일 검증 절차
- 버전을 고정해 기록한다. 요청 날짜, 응답 헤더에 제공되는 버전,
deepseek-flash, 하네스 커밋을 한 줄에 남긴다. - 업무 30개를 만든다. 코드 수정 10, 도구 호출 10, 긴 문서·이미지 10개를 고정하고 정답 조건과 금지 행동을 먼저 적는다.
- 설정을 통일한다. 공식 권장 temperature 1.0, top_p 1.0을 시작점으로 삼되 실제 운영값도 별도 군으로 시험한다.
- 각 과제를 세 번 반복한다. 일회성 성공이 아니라 완료율, 산포, 재시도, 도구 오류를 기록한다.
- 정확도와 비용을 함께 잰다. 입력·출력·캐시 토큰, 벽시계 시간, 사람 수정분을 모아 성공 작업당 비용을 계산한다.
- 9월 빌드가 없으면 현재 대조 모델을 둔다. 과거 스크린샷 대신 동일 날의 주력 모델을 같은 하네스와 예산으로 비교한다.
- 배포 기준을 미리 정한다. 완료율 비열등, 중대한 오류 0, 작업당 비용 15% 이상 절감처럼 통과선을 결과 전에 고정한다.
트렌드매그는 이번 실행에서 DeepSeek API, 공개 가중치, deepseek-recipe, Claude Code 하네스를 직접 실행하지 않았다. 위 절차는 재현 가능한 운영 설계이며 테스트 결과가 아니다. 따라서 hands_on_tested=false로 기록했다.
반론과 과장 가능성
- “독립 점수가 없으니 가치가 없다”는 결론도 과하다. 같은 회사 표에서 모든 항목이 상승했고 MIT 가중치까지 공개돼 외부 검증은 가능하다.
- “API 이름과 가격이 같으니 완전한 무위험 업그레이드”는 틀리다. 응답 길이·도구 호출·안전 거절·프롬프트 인코딩이 바뀌면 회귀가 생길 수 있다.
- “1M 문맥이면 1M 토큰을 안정적으로 이해한다”는 뜻이 아니다. 지원 상한과 장문 정보 회수 품질은 별도 측정 대상이다.
- “MIT면 저렴하게 로컬 실행된다”도 성립하지 않는다. 라이선스 자유와 수백 GB 가중치를 운영하는 하드웨어 비용은 별개다.
- “짧은 출력은 항상 좋다”는 주장도 위험하다. 코딩 에이전트가 설명·검증 단계를 생략하면 재시도와 사람 검수가 늘 수 있다.
분석의 한계
- 1017의 벤치마크 원본 로그, 샘플별 결과, 작업 시간·출력 토큰 감소율은 공개되지 않았다.
- 독립 평가기관의 1017 고정 버전 점수가 아직 확인되지 않았다.
- Hugging Face의 763B 표시와 9월 발표의 552B 백본은 집계 범위가 달라 직접 비교하지 않았다.
- 가격은 2026년 10월 18일 확인값이며 공급자가 변경할 수 있다.
- 벤치마킹 블로그 일부는 교육·라우터·워크플로 제품을 판매하는 상업적 매체다.
지금 할 일
deepseek-flash를 이미 쓴다면 오늘 30개 회귀 묶음을 돌리고, 모델 별칭만이 아니라 실행 날짜와 공급자 버전을 로그에 남긴다. 새로 도입한다면 먼저 API로 성공 작업당 비용을 계산하고, 자체 호스팅은 그 뒤에 검토한다. 모델 선택 기준은 AI 도입 로드맵, 도구 목록은 AI 도구, 분석 원칙은 AI 인사이트에서 이어진다. 긴 문맥·가격 주장 검증은 Mistral Large 4 분석, 프리뷰와 외부 벤치마크 분리는 Gemini 4 Argon 분석과 비교할 수 있다.
3줄 요약
- DeepSeek은 10월 17일
deepseek-flash를 1017로 교체하고 웹·앱·API와 MIT 가중치를 함께 공개했다. - 11개 점수 상승과 짧은 출력은 아직 회사 평가이며, 1017 독립 점수와 절감 비율은 확인되지 않았다.
- 같은 가격이라도 캐시·출력·재시도에 따라 비용이 달라지므로 고정 30개 과제로 완료율과 작업당 비용을 다시 재야 한다.
공식 출처
- DeepSeek API Change Log — 2026-10-17 업데이트
- DeepSeek‑V4.1‑Flash‑1017 공식 모델 카드·MIT 가중치
- DeepSeek Models & Pricing — 2026-10-18 확인
- DeepSeek recipe — 공식 프롬프트 인코딩 도구