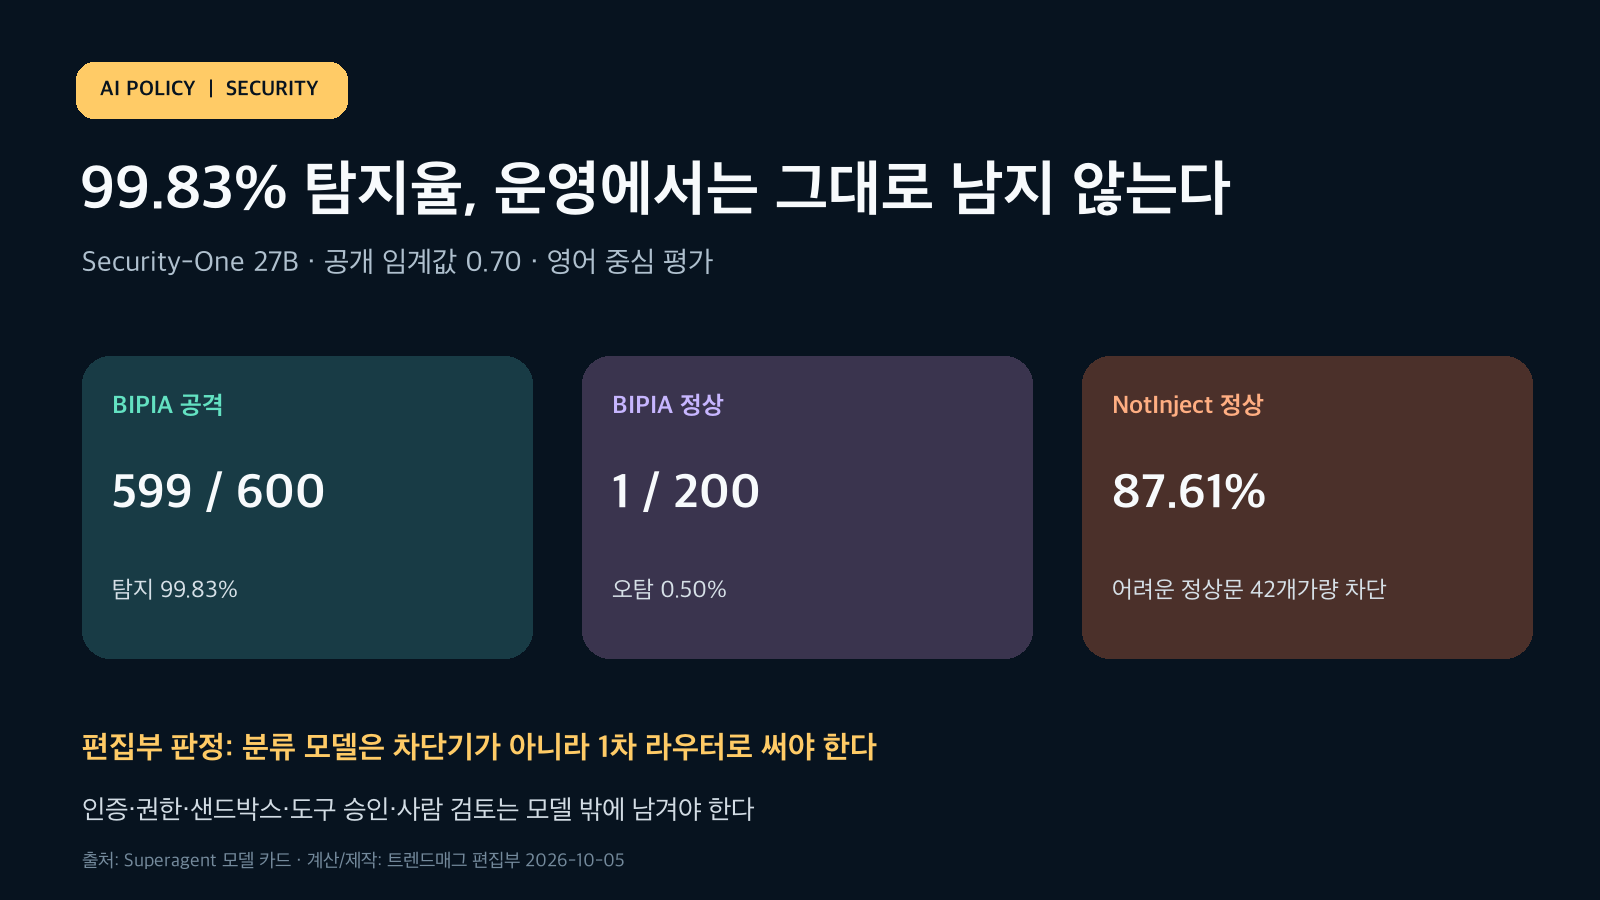
첫 필터로 시험할 가치는 높지만 공개 BIPIA 수치를 자동 차단 성능으로 일반화하면 안 된다. 한국어·실제 공격 비율·오탐 비용으로 임계값을 다시 정하고 결정적 통제를 별도로 둬야 한다.
- BIPIA 공격 탐지
- 599/600, 99.83% 근거 ↗
- BIPIA 정상 오탐
- 1/200, 0.50% 근거 ↗
- Deepset 공격 탐지
- 47/60, 78.33% 근거 ↗
- NotInject 정상 정확도
- 87.61%, 약 42/339 오탐 근거 ↗
- 검증 문맥
- 65,536 tokens 근거 ↗
- 1% 공격 시 경보 정밀도
- 약 66.9% 가상 계산 근거 ↗
자료 조사·초안 구성에 자동화 도구를 활용할 수 있으며, 공개된 글의 수정과 최종 책임은 트렌드매그 운영자에게 있습니다.
결론부터 말하면 Security-One 27B의 ‘공격 599건 중 599건 탐지’는 보안팀이 곧바로 자동 차단에 써도 된다는 뜻이 아니다. 에이전트·RAG·업무 자동화를 운영하는 팀은 이 모델을 1차 분류기로 시험하되, 실제 트래픽의 공격 비율과 한국어 오탐을 측정한 뒤 사람 검토와 결정적 통제 앞에 배치해야 한다.
작성자: 트렌드매그 편집부 · 검수자: 트렌드매그 AI 편집 기준 · 최종 업데이트: 2026-10-05 (Asia/Seoul)
먼저 확인한 사실
| 항목 | 2026-10-05 확인값 | 트렌드매그 판정 |
|---|---|---|
| 공개일 | 2026년 10월 4일 | 실행 시점 기준 48시간 이내 발표다. |
| 모델 | 27B, BF16 SafeTensors 15개 샤드 | 대화 모델이 아니라 확률을 내는 보안 의사결정 모델이다. |
| 배포 | Apache 2.0 오픈웨이트·호스팅 API | 파일 접근에는 Hugging Face 연락처 공유 동의가 필요하며 공개 추론 제공자는 표시되지 않았다. |
| 대표 수치 | BIPIA 공격 599/600 탐지, 정상 1/200 오탐 | 고정 임계값 0.70의 회사 측 재구성 평가다. |
| 반대 신호 | Deepset 공격 탐지 78.33%, NotInject 정상 정확도 87.61% | 데이터 분포가 바뀌면 탐지와 과잉 차단이 크게 달라진다. |
| 언어·운영 | 영어 중심 평가, 권장 검증 구성은 NVIDIA B200·SGLang | 한국어와 다른 GPU·양자화 환경은 별도 검증 대상이다. |
무엇이 바뀌었는가: 답변 생성 대신 경보를 라우팅한다
Superagent가 10월 4일 공개한 Security-One 27B는 일반 챗봇처럼 긴 답을 만드는 모델이 아니다. 프롬프트, 도구 호출, 코드 변경, 로그와 경보를 받아 선택지별 확률을 내고, 낮은 위험은 모니터링하고 애매한 사건은 더 강한 모델이나 사람에게 넘기는 구조다. 모델 카드는 평범한 채팅 완성 방식으로는 공개 결과를 재현할 수 없으며 SGLang용 프롬프트·리드아웃 방식을 사용해야 한다고 명시한다.
이 방향은 에이전트 보안의 병목을 정확히 겨냥한다. 메일·웹페이지·문서처럼 신뢰할 수 없는 데이터 안에 숨은 명령은 사용자의 지시처럼 보일 수 있다. BIPIA 연구는 이 문제를 외부 콘텐츠와 실행할 명령을 구분하지 못하는 데서 찾았고, 최근 TechRadar가 전한 Manus 사례에서도 난독화된 이메일 명령이 보호 장치를 우회한 뒤 코드 실행으로 이어질 수 있었다. 탐지 모델이 필요한 이유는 분명하다.
하지만 모델 카드 자체도 Security-One이 통제 평면이 아니라 통제 평면에 증거를 공급하는 층이라고 선을 긋는다. 인증, 권한 부여, 샌드박스, 속도 제한과 같은 결정적 통제는 모델 밖에 남겨야 한다. 이 문장이 ‘항상 켜진 보안 모델’이라는 홍보 문구보다 더 중요하다.
99.83%는 무엇을 측정했고 무엇을 측정하지 않았나
공식 비교표의 BIPIA 적응 평가는 800행으로, 공격 600개와 정상 200개다. 위험 확률이 0.70 이상이면 unsafe로 처리했을 때 공격 599개를 잡고 정상 1개를 잘못 막았다. 공격 재현율 99.83%, 정상 오탐률 0.50%, 전체 정확도 99.75%다. 같은 표만 보면 거의 완성된 방어처럼 보인다.
그러나 이 평가는 원래의 생성형 BIPIA 리더보드가 아니라 이메일·표·코드 문맥을 이진 분류로 바꾼 적응 평가다. 회사가 고정한 행과 자체 리드아웃으로 측정했고, 공개 결과는 독립기관의 재시험이 아니다. 더구나 공격이 전체의 75%인 구성은 실제 업무 트래픽의 공격 비율과 크게 다를 수 있다.
| 평가 | 행 수 | Security-One 결과 | 읽는 법 |
|---|---|---|---|
| BIPIA 공격 | 600 | 99.83% 탐지 | 공격 1개를 놓친 셈이다. |
| BIPIA 정상 | 200 | 0.50% 오탐 | 정상 1개를 공격으로 분류했다. |
| Deepset 공격 | 60 | 78.33% 탐지 | 다른 공개 데이터에서는 약 13개를 놓친다. |
| NotInject 정상 | 339 | 87.61% 정상 통과 | 공격처럼 보이는 정상문 약 42개를 막는 수준이다. |
NotInject는 ‘ignore’나 ‘cancel’처럼 공격에 자주 등장하는 단어를 포함하지만 의도는 정상인 339개 문장으로 과잉 방어를 측정한다. 원 논문은 기존 가드 모델이 이런 정상문을 공격으로 오해할 수 있음을 보여준다. Security-One의 87.61%는 BIPIA의 0.50% 오탐과 모순이 아니라, 쉬운 정상문과 어려운 정상문의 분포가 다르다는 신호다.
고유 결과물 1: 공격 비율을 바꾸면 경보의 질이 바뀐다
BIPIA 수치인 탐지율 99.83%와 정상 오탐률 0.50%가 운영에서도 그대로 유지된다고 가정해 보자. 하루 10,000건 중 공격이 1%라면 실제 공격 약 99.8건을 잡는 동안 정상 약 49.5건도 경보가 된다. 이때 경보 중 진짜 공격 비율은 약 66.9%다. 공격이 0.1%라면 진짜 공격 약 10건보다 정상 오탐 약 50건이 많아져 경보의 양성 예측도는 약 16.7%로 내려간다.

| 10,000건 중 공격 비율 | 잡힌 공격 | 정상 오탐 | 경보 중 실제 공격 |
|---|---|---|---|
| 10% | 약 998.3건 | 45.0건 | 95.7% |
| 1% | 약 99.8건 | 49.5건 | 66.9% |
| 0.1% | 약 10.0건 | 50.0건 | 16.7% |
계산식은 양성 예측도 = 탐지율×공격 비율 ÷ (탐지율×공격 비율 + 오탐률×정상 비율)이다. 이는 공개 수치로 만든 가상 시나리오이지 실제 운영 성능 보장이 아니다. 다만 왜 ‘탐지율 하나’보다 내 트래픽의 공격 비율, 오탐 비용, 사람 검토 용량이 중요한지는 분명히 보여준다.
고유 결과물 2: 자동 차단이 아니라 세 갈래 라우팅으로 시작한다
| 분류 구간 | 권장 동작 | 반드시 남길 통제 |
|---|---|---|
| 낮은 위험 | 허용하되 로그와 표본 검수 | 도구 권한 최소화, 민감정보 마스킹 |
| 중간·불확실 | 더 강한 모델 또는 보안 담당자에게 전달 | 외부 전송·삭제·결제는 실행 보류 |
| 높은 위험 | 해당 입력과 연쇄 도구 호출 차단 | 세션 격리, 자격증명 폐기, 사고 기록 |
첫 배포에서 0.70을 절대선으로 복사하지 말고 두 임계값을 둔다. 낮은 임계값 아래는 모니터링, 중간 구간은 검토, 높은 임계값 위는 제한된 차단으로 보낸다. 고위험이라도 모델이 직접 계정을 삭제하거나 비밀키를 폐기하게 해서는 안 된다. 모델은 경보의 근거를 만들고, 실행 권한은 코드와 사람이 소유해야 한다.
국내 크리에이터·전문 블로그의 실전 사례
지정된 벤치마킹 목록에서 이번 주제와 직접 연결되는 공개 자료로는 MindStudio의 프로덕션 에이전트 배포 가이드를 확인했다. 이 글은 시스템 프롬프트만을 안전장치로 취급하지 말고 입력·출력 검증, 권한 범위, 예산 제한, 관찰 가능성, 카나리 배포를 함께 두라고 제안한다. Security-One을 ‘첫 필터’로 놓되 도구 권한과 감사 로그를 분리하라는 이번 판정과 맞닿는다.
MindStudio는 에이전트 플랫폼을 판매하고 자사 인프라를 소개하는 상업적 맥락이 있다. 따라서 수치 근거로 사용하지 않고 운영 체크리스트의 사례로만 썼다. 지정된 국내 유튜브 채널에서는 발표 뒤 48시간 안에 제목뿐 아니라 설명·챕터·공개 자막까지 확인 가능한 Security-One 실사용 사례를 찾지 못해 인용하지 않았다. 최근 Manus 이메일 우회 사례는 TechRadar 기사와 Salt Labs 연구 경로로 사실관계를 보완했다.
직접 재현 가능한 검증 절차
- 내 트래픽 1,000건을 익명화한다. 정상 800건, 공격·레드팀 100건, 공격 단어를 포함한 정상문 100건처럼 실제 비율과 별도 스트레스 표본을 나눈다.
- 한국어 난이도를 분리한다. 고객 문의, 보안 문서, 코드 주석, 번역 요청, ‘무시’·‘삭제’가 정상 의미로 쓰인 문장을 따로 태깅한다.
- 공개 레시피를 고정한다. 모델 리비전, SGLang 버전, BF16·양자화, 문맥 길이, 임계값과 프롬프트 형식을 기록한다. 일반 채팅 API로 결과를 비교하지 않는다.
- 임계값 곡선을 만든다. 0.50·0.60·0.70·0.80·0.90에서 공격 재현율, 정상 오탐률, 어려운 정상문 통과율을 함께 계산한다.
- 업무 비용을 붙인다. 놓친 공격 1건의 예상 손실, 정상 차단 1건의 처리시간, 하루 사람 검토 한도를 정해 임계값을 선택한다.
- 도구 호출을 별도 시험한다. 메일 읽기, 파일 쓰기, 외부 전송, 삭제, 결제마다 최소 권한과 승인 단계를 확인한다. 분류 모델 통과가 실행 허가가 되지 않게 한다.
- 카나리로 배포한다. 읽기 전용 트래픽 5%에서 7일간 관찰한 뒤 언어·도메인별 드리프트와 오탐을 재측정한다.
회사 주장과 트렌드매그 판정
| 주장 | 확인 근거 | 편집부 판정 |
|---|---|---|
| 항상 켜진 보안 분류층 | 모델 카드·API 저장소 | 역할은 타당하지만 B200 검증 구성과 27B 규모는 가벼운 엣지 필터가 아니다. |
| BIPIA 공격 99.83% 탐지 | 회사 제공 고정 평가 | 재현 가능한 중요 신호지만 독립 재시험과 운영 공격 비율이 빠져 있다. |
| 응용·코드·인프라까지 분류 | 의도된 사용 범위 | 프롬프트 인젝션 외 영역은 동등하게 검증된 벤치마크 주장으로 보면 안 된다. |
| 보정된 확률 | 보정 온도와 임계값 공개 | 언어·도메인·양자화가 바뀌면 보정도 이동할 수 있다. |
| 오픈웨이트 | Apache 2.0, BF16 체크포인트 | 감사 가능성은 장점이지만 정확한 학습 코퍼스는 번들에 포함되지 않았다. |
반론과 과장 가능성
- “다른 데이터셋에서 78.33%면 쓸모없다”는 결론도 성급하다. 이 모델의 가치는 최종 판결보다 저비용 1차 라우팅에 있을 수 있다. 다만 놓친 공격이 도구 실행으로 직결되지 않게 해야 한다.
- “99.83%면 프롬프트 인젝션이 해결됐다”는 주장은 틀리다. 모델 카드도 완전한 보안 경계가 아니라고 명시하고, 최근 실제 공격은 난독화와 연쇄 권한을 이용했다.
- “오픈웨이트면 검증이 끝났다”도 아니다. 가중치 공개는 재현성을 높이지만 학습 데이터 전체, 한국어 성능, 다른 추론 엔진의 보정은 별도 문제다.
- “정상 오탐 0.5%는 무시할 수 있다”는 판단은 트래픽 규모에 따라 틀릴 수 있다. 하루 100만 건이면 같은 비율로 정상 경보 5,000건이 생긴다.
- “모델 하나로 권한 설계를 대신할 수 있다”는 가장 위험한 과장이다. 인증·샌드박스·승인·감사 로그가 없으면 오분류 한 번이 바로 사고가 된다.
분석의 한계
- 트렌드매그는 27B 가중치를 내려받거나 B200·SGLang 환경에서 모델을 직접 실행하지 않았다.
- BIPIA·Deepset·NotInject 수치는 Superagent의 공개 모델 카드에서 가져왔으며 원시 점수를 독립 재계산하지 않았다.
- BIPIA 적응 평가는 원래 생성형 벤치마크와 동일하지 않고, NotInject는 정상문 전용이라 공격 재현율을 측정하지 않는다.
- 평가는 주로 영어이며 한국어, 장문 도구 출력, 멀티모달 입력, 양자화 모델 성능은 확인되지 않았다.
- 호스팅 API의 가격·처리량·지역·보존 정책은 공개 자료에서 확정하지 못했다.
지금 할 일
- 에이전트가 읽는 메일·웹·문서와 실행 가능한 도구의 연결 목록부터 만든다.
- 한국어 어려운 정상문을 포함한 1,000건 검증셋으로 임계값별 오탐·누락 비용을 계산한다.
- Security-One은 읽기 전용 1차 라우터로 시작하고 외부 전송·삭제·결제에는 결정적 승인 규칙을 둔다.
- 모델·프롬프트·추론 엔진이 바뀔 때마다 보정을 다시 측정하고 카나리 결과를 기록한다.
도입 순서는 AI 로드맵, 모델 탐색은 AI 도구, 후속 분석은 AI 인사이트에서 이어갈 수 있다. 권한 설계에는 OpenAI Dots 권한·기억 분석, 사고 대응에는 에이전트 샌드박스 사고 분석, 브라우저 자동화에는 AI 브라우저 승인 지점 체크리스트가 연결된다.
3줄 요약
- Security-One 27B는 10월 4일 공개된 오픈웨이트 보안 분류 모델로, BIPIA에서 공격 599/600을 탐지했다.
- Deepset 공격 탐지 78.33%, NotInject 정상 정확도 87.61%는 데이터 분포와 오탐 비용을 따로 봐야 함을 보여준다.
- 자동 차단기가 아니라 1차 라우터로 검증하고 인증·권한·샌드박스·사람 승인은 모델 밖에 남겨야 한다.
공식 출처
- Superagent — 2026-10-04 Security-One 27B 공개 변경 기록
- Hugging Face — Security-One 27B 모델 카드·평가·제한
- GitHub — SystemOne API·SGLang 배포·확률 출력 규격
독립 출처와 벤치마킹 자료
- BIPIA 논문 — 간접 프롬프트 인젝션 벤치마크
- InjecGuard·NotInject 논문 — 과잉 방어 정상문 평가
- TechRadar — 2026-10-02 Manus 이메일 프롬프트 인젝션 우회 (제휴 링크 고지 매체)
- MindStudio — 프로덕션 에이전트 가드레일·카나리 배포 (에이전트 플랫폼 운영사의 상업적 맥락 있음)
편집 원칙: 발표일·모델 구조·수치·제한은 공개 원문과 논문에서 대조했다. 트렌드매그는 모델을 직접 실행하지 않았으며, 회사 평가를 독립 벤치마크 결과처럼 표현하지 않았다.