
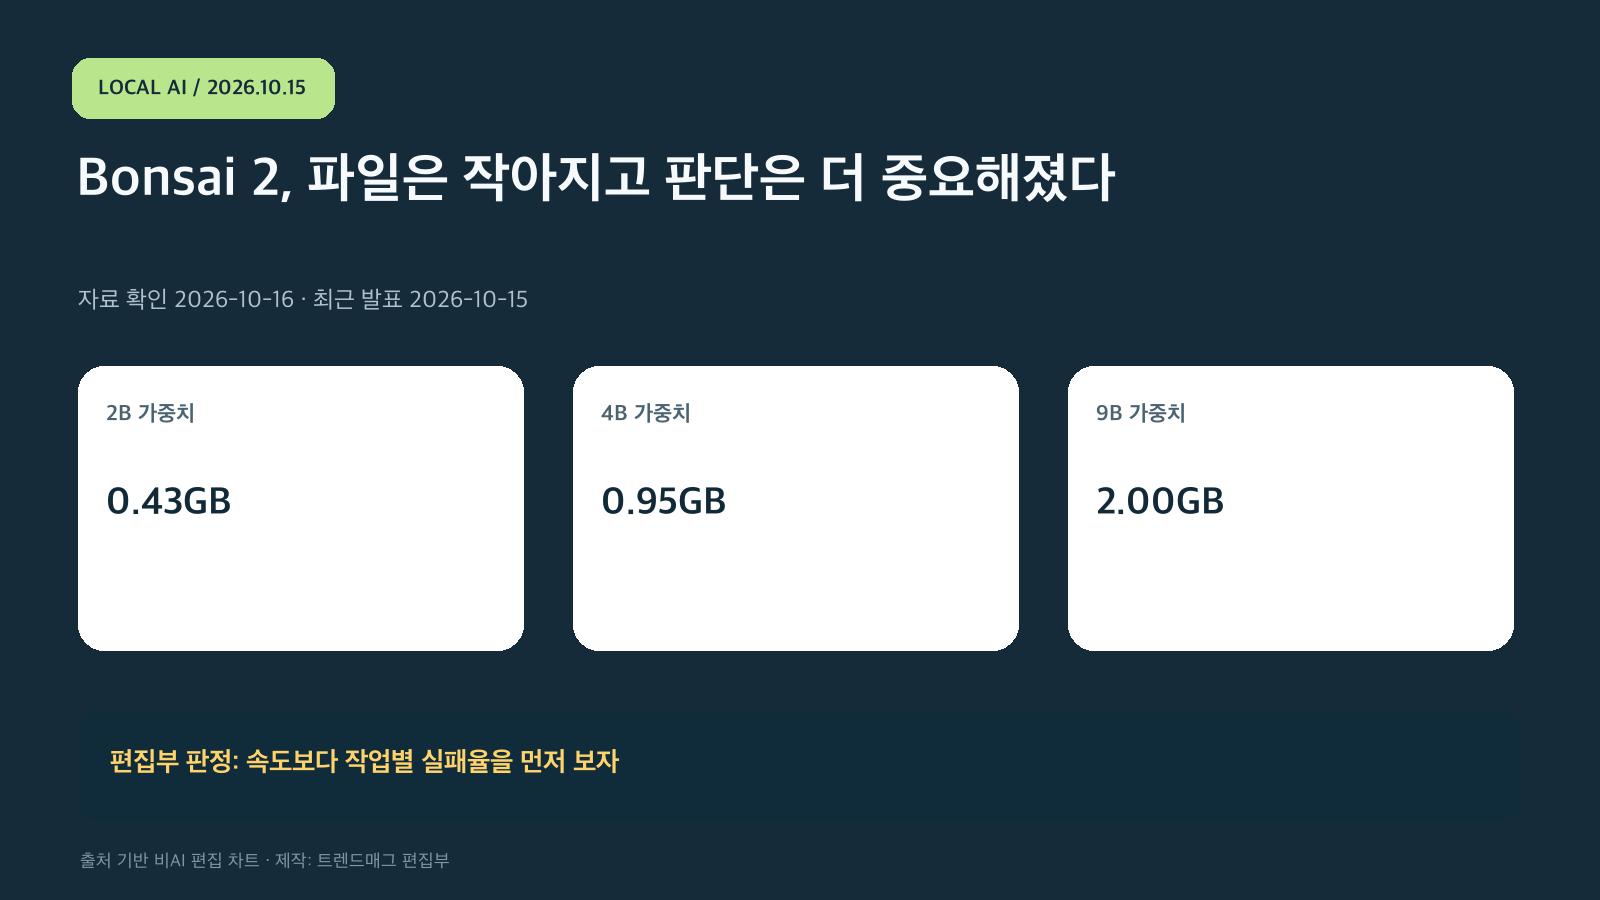
가중치 크기는 작지만 추론·도구 실행의 약한 구간을 직접 시험해야 한다.
자료 조사·초안 구성에 자동화 도구를 활용할 수 있으며, 공개된 글의 수정과 최종 책임은 트렌드매그 운영자에게 있습니다.
0.43GB짜리 AI 모델이 휴대전화에서 도구까지 사용할 수 있다면, 클라우드 없이 작동하는 비서의 경계가 달라진다. PrismML이 10월 15일 공개한 Ternary Bonsai 2 2B·4B·9B는 바로 이 가능성을 시험하는 새 선택지다. 다만 ‘9분의 1 크기’라는 숫자만 보고 기존 모델과 성능이 같거나 모든 폰에서 바로 쓸 수 있다고 결론 내리면 안 된다. 이 글은 실제 공개 수치에서 무엇이 줄었고 어떤 능력이 약해졌는지, 개발자가 무엇을 다시 시험해야 하는지 분리한다.
작성자: 트렌드매그 편집부 · 검수자: 트렌드매그 AI 편집 기준 · 최종 업데이트: 2026-10-16 (Asia/Seoul) · 직접 모델 실행: 하지 않음 · 자료 기반 분석
새로 나온 것은 세 가지 크기의 로컬 모델이다
PrismML의 발표에 따르면 새 모델은 Qwen3.5의 2B·4B·9B를 바탕으로 가중치를 −1·0·+1의 세 값으로 표현한다. 제조사가 공개한 모델 파일의 크기는 각각 0.43GB, 0.95GB, 2.00GB다. 이전에 나온 27B와 합치면 제품군은 네 크기가 된다. 모델 저장소에는 GGUF와 Apple MLX 형식이 올라와 있고, 회사는 Apache 2.0 라이선스로 가중치를 제공한다고 밝힌다. macOS·iPhone·iPad의 MLX와 NVIDIA GPU의 llama.cpp 경로를 제시하지만, 실제 작동 여부는 기기 메모리와 런타임·버전, 모델 파일 종류에 따라 확인해야 한다.
0.43GB는 기기에서 필요한 전체 메모리와 동일하지 않다. 가중치 파일 외에 실행 프로그램, KV 캐시, 이미지 입력과 긴 대화 이력, 다른 앱이 쓰는 메모리가 더해진다. ‘내 휴대전화에서 2GB 모델이 들어간다’와 ‘배터리를 견디며 빠르게 응답한다’도 다른 주장이다. 회사가 제시한 iPhone 18 Pro Max의 9B 최대 초당 34토큰, 2B 최대 120토큰과 M5 Max Pro에서의 수치는 특정 시연·측정 조건의 회사 자료다. 한국 사용자의 구형 기기나 장시간 발열 상황까지 확인한 수치는 아니다.
작아진 크기와 성능 보존율은 같은 이야기가 아니다
PrismML은 19개 벤치마크를 여섯 능력 영역으로 묶어 원본 Qwen3.5와 비교했다. 자체 공개표에서 9B의 도구 사용 영역 평균 보존율은 92.4%, 지식·추론은 93.0%, 시각은 92.5%다. 그러나 2B의 지식·추론은 82.9%로 낮고, GPQA Diamond는 39.6점 대 58.48점으로 67.7%에 그친다. 4B의 Tau2Bench도 61.87점 대 81.65점, 75.8%다. 실사용에서 오류 비용이 큰 과제를 맡길 때 전체 평균보다 이런 약한 부분이 더 중요하다.
| 선택지 | 발표한 가중치 파일 크기 | 발표에서 눈에 띄는 약점 | 편집부의 우선 시험 |
|---|---|---|---|
| Bonsai 2 2B | 0.43GB | GPQA Diamond 원본 대비 67.7% | 짧은 분류·요약과 실패율부터 측정 |
| Bonsai 2 4B | 0.95GB | Tau2Bench 원본 대비 75.8% | 연속 도구 호출과 중단 복구 점검 |
| Bonsai 2 9B | 2.00GB | 지식·추론 93.0%, 시각 92.5% 보존 | 문서·이미지·도구를 함께 쓰는 과제 점검 |
보존율은 ‘원본의 정확도 몇 퍼센트를 남겼는가’라는 자체 비교이며 모든 응답이 동일하다는 뜻이 아니다. 일부 수학·코딩 시험에서는 압축형이 원본보다 높게 나왔다. 이것 역시 ‘압축하면 더 똑똑해진다’는 일반 법칙이 아니라 평가 설정과 작은 점수 차이를 살펴야 한다는 신호다. 제조사가 공개한 기술 백서는 세부 설정을 확인하는 출발점이지만, 모델 제공자가 선정·수행한 평가라는 이해관계는 남는다. 일본 PC Watch의 보도도 수치와 다운로드 경로를 요약했을 뿐, 동일 조건의 독립 재현 결과로 읽어서는 안 된다.

‘로컬 에이전트’라면 벤치마크보다 권한부터 물어야 한다
문서를 읽고 메모 앱에 옮기는 도우미라면 모델의 정답률뿐 아니라 읽기 권한, 파일 경로, 외부 도구 호출 범위를 확인해야 한다. 추론이 로컬에서 이루어져도 앱이 클라우드 동기화나 원격 로그를 사용할 수 있고, 모델이 잘못된 파일을 수정할 가능성도 남는다. ‘로컬’은 데이터가 어느 곳에서 계산되는지를 설명하는 말이지 모든 데이터가 어떤 상황에서도 밖으로 나가지 않는다는 보안 인증이 아니다. 특히 화면 캡처와 메일 내용을 입력할 경우 제3자 앱의 저장·권한 정책을 별도로 확인해야 한다.
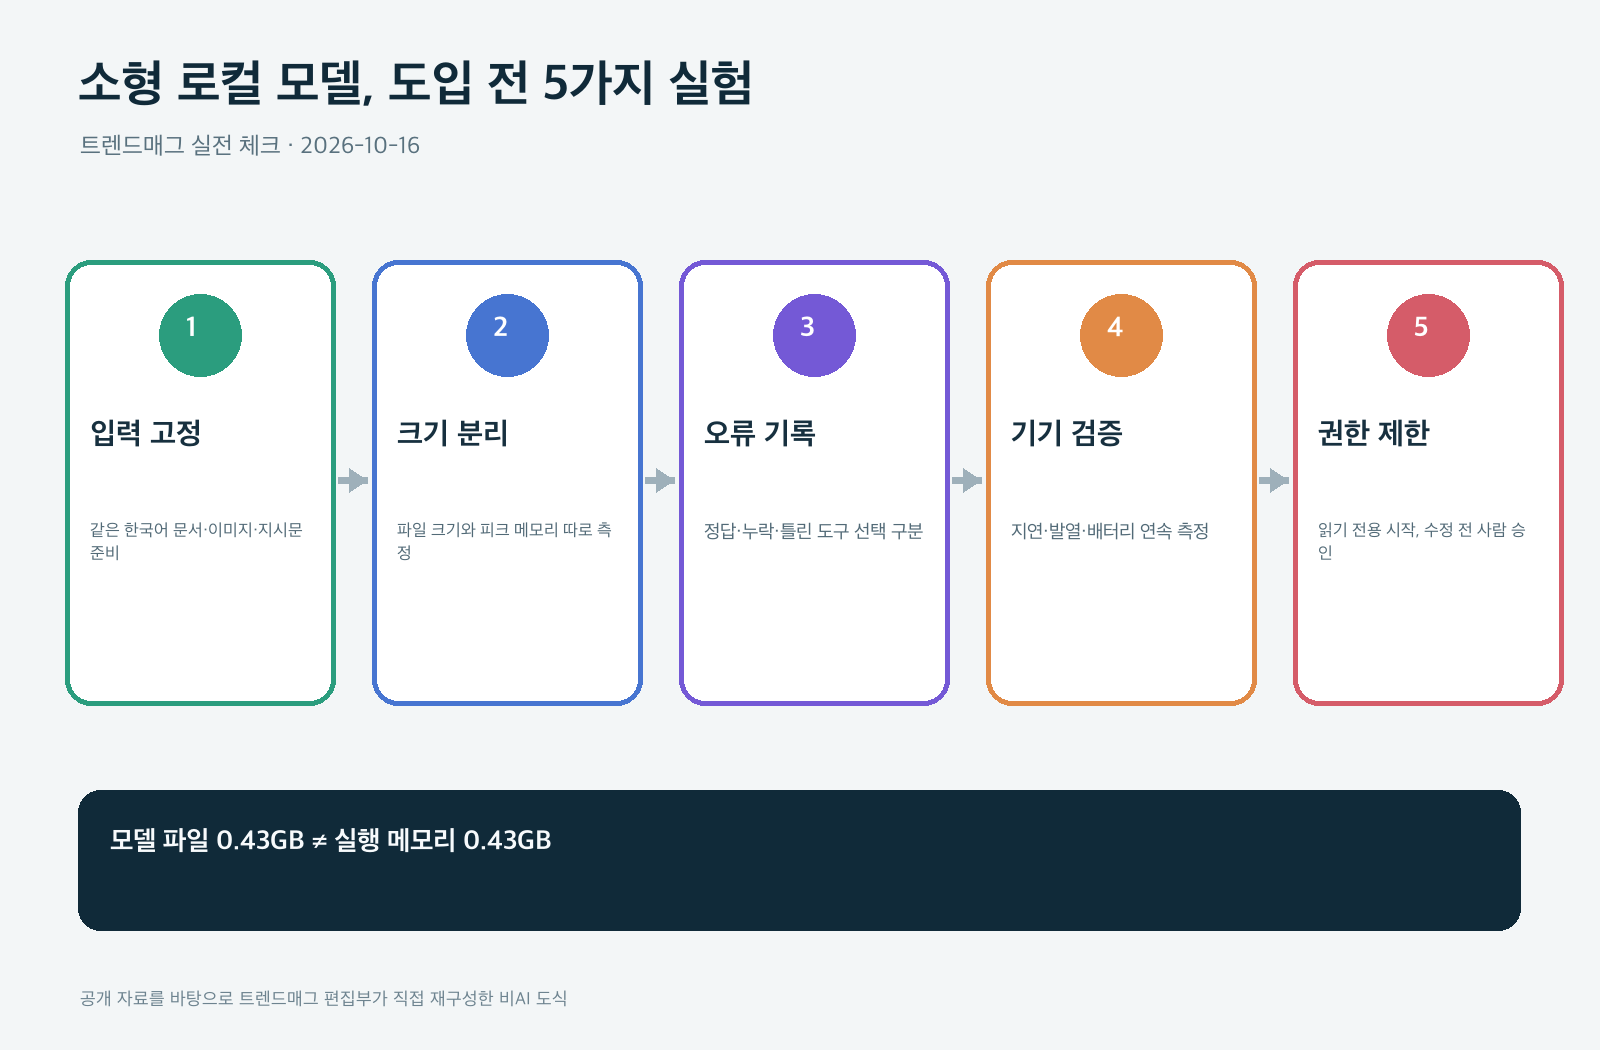
트렌드매그가 권하는 첫 실험은 읽기 전용 과제다. 연락처 20건 중 조건에 맞는 항목을 찾거나, 개인 식별 정보를 제거한 문서 10개를 분류하되 실제 삭제·전송은 막는다. 출력의 정답률만 보지 말고 누락, 잘못된 도구 선택, 같은 작업 반복, 금지 파일 접근 시도를 기록한다. 다음 단계에서 사람 승인 후 한 파일만 수정하게 하고, 수정 전 사본과 되돌리기 경로를 둔다. 네트워크 없는 모드와 네트워크가 켜진 모드의 연결 기록도 비교해야 ‘로컬 전용’ 주장에 가까워진다.
10분 재현 실험: 같은 작업을 세 크기에 준다
모델을 고를 때는 ‘어느 것이 가장 빠른가’가 아니라 ‘내 작업에서 허용할 오류를 만족하는 가장 작은 모델은 무엇인가’를 물어야 한다. 예를 들어 영수증 30장의 금액·날짜 추출이라면 같은 이미지, 같은 지시문, 같은 출력 형식, 같은 하드웨어, 같은 런타임으로 2B·4B·9B를 비교한다. 각 모델을 3회씩 돌려 정답률과 응답 시간을 함께 적고, 이미지가 흐리거나 날짜 형식이 다른 실패 입력을 5장 포함한다. 모델이 값을 못 읽었을 때 빈칸을 주는지, 틀린 숫자를 자신 있게 쓰는지 구별한다.
비교표에는 가중치 파일 크기와 실제 실행 중 최고 메모리 사용량을 따로 적는다. 첫 토큰이 나오기까지 걸린 시간과 전체 생성 시간을 구분하고, 발열·배터리는 1회가 아니라 연속 실행 뒤 확인한다. 같은 0.43GB 파일도 긴 문맥을 쓰면 캐시가 커질 수 있다. 스마트폰에서 시연된 속도를 노트북이나 웹 브라우저로 옮겨 적지 않는다. 우리 팀이 쓰려는 도구 기능이 MLX 빌드에서 지원되는지도 직접 봐야 한다.
운영 비용을 계산할 때도 저장 공간 절감만 볼 수 없다. 예를 들어 하루 1만 건의 분류에서 오류가 1%라면 사람 재검토가 필요한 건수는 100건이다. 모델을 작게 만들어 전력비를 아껴도 오류가 3%가 되면 재검토는 300건으로 늘어난다. 이 계산은 Bonsai 2의 실제 오류율을 뜻하지 않는 가상의 예시다. 중요한 것은 작은 모델이 절약한 컴퓨팅 비용과 사람이 고치는 비용을 같은 표에 놓는 방법이다. 중요도가 높은 요청에는 2B가 확신하지 못할 때 9B나 사람에게 넘기는 단계적 설계도 가능하다. 다만 모델이 스스로 말한 확신도가 실제 정답률과 일치하는지는 별도의 보정 시험이 필요하다.
한국어 사용자에게는 별도 검증이 필요하다
회사 공개표의 주된 과제는 다국어 한국어 업무 성능을 충분히 설명하지 않는다. 한국어 조사, 문장 끝의 존댓말, 영수증의 ‘합계/과세/면세’ 구분, 국내 주소와 날짜 형식은 일반 영어 벤치마크와 다르다. 한국어 OCR 20건, 한국어 도구 호출 20건, 영어와 섞인 입력 20건을 따로 만들어 오류 유형을 기록하자. 특히 2B가 영어 짧은 명령을 잘 따라도 한국어 복합 지시에서 빠뜨리는 조건이 있을 수 있다. 이것은 아직 측정하지 않은 위험 가설이지 Bonsai 2의 결함으로 확인된 사실은 아니다.
라이선스가 Apache 2.0이라고 해서 앱 개발의 모든 요소가 같은 조건인 것도 아니다. 모델 가중치와 변환 코드, 추론 엔진, 함께 배포하는 데이터셋의 권리를 따로 본다. 상업 제품에 넣는다면 모델 카드의 사용조건과 재배포 안내, 타사 원본 모델의 조건을 확인한다. 공개 파일이 있다는 것과 안전한 제품 배포가 끝났다는 것을 혼동하지 말자.
트렌드매그 판정과 지금 할 일
편집부의 판정은 ‘작은 기기에서 모델을 시험하기 위한 현실적인 폭이 넓어졌다’이다. 0.43·0.95·2.00GB라는 가중치 크기와 공개 파일은 검증 가능한 진전이다. 그러나 ‘9배 압축하면서 거의 같은 성능’은 작업 종류마다 다르고, GPQA와 Tau2Bench 같은 예외가 이미 제조사 표 안에 있다. 회사 수치, 독립 측정, 한국어 실사용을 한 줄로 합쳐 말하지 않겠다. 직접 실행·벤치마크는 하지 않았다.
지금 개발자가 할 일은 세 가지다. 첫째, 공식 모델 저장소에서 실제 지원 형식과 라이선스를 확인한다. 둘째, 쓰려는 기기의 피크 메모리·응답 시간·배터리를 같은 입력으로 기록한다. 셋째, 업무별 허용 오류 기준을 먼저 정하고 2B부터 9B까지 올라가며 충분한 모델을 고른다. 더 큰 모델이라는 이유만으로 최선도 아니고, 더 작은 파일이라는 이유만으로 개인정보 보호가 완성되는 것도 아니다.
세 줄 요약: Bonsai 2는 10월 15일 2B·4B·9B를 추가했다. 가중치가 작아졌지만 일부 추론·도구 과제의 성능 손실은 크다. 로컬 도입 판단은 기기별 메모리와 한국어 업무 실패율을 직접 잰 뒤 해야 한다.
자료: PrismML 제품·벤치마크 발표 · 배포·라이선스 발표 · 공식 모델 저장소 · 기술 백서 · PC Watch의 별도 보도. 성능 수치는 제조사 측정이며 트렌드매그의 실측 결과가 아니다.